Présentation de l'ensemble de données audio/vidéo multimodal chinois 2022
800 personnes à travers 7 émotions : l'ensemble de données faciales multi-expressions définitives et l'ensemble de données de reconnaissance audio
« 2022 800 Chinese Multi-modal audio/video dataset », capturant un ensemble de données d'imagerie faciale et des enregistrements de données audio de 800 individus différents, couvrant les deux sexes.
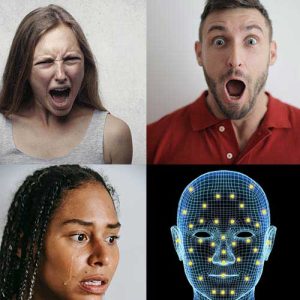
Soyez témoin de la granularité des sujets qui expriment 7 émotions distinctes : naturel, heureux, dégoût, surprise, peur, colère et tristesse. Chaque émotion est représentée par 10 phrases, soit un total impressionnant de 70 phrases par sujet, en utilisant 2 smartphones - un dédié à la vidéo et un autre à l'audio - ainsi qu'un microphone spécialisé pour une capture audio impeccable. Chaque point de données a été aligné manuellement, garantissant une précision inégalée pour vos efforts de reconnaissance faciale et audio. Plongez dans une solution complète de données faciales multi-expressions et positionnez-vous à l'avant-garde du secteur de l'IA.